Claude Code für SEO: ein Arbeitsablauf mit Prüfschritten
Claude Code ist ein Programm von Anthropic, das im Terminal läuft, den Code eines Projekts liest, Dateien ändert und Befehle ausführt. Für SEO heißt das: Es kann eine Website, die als Code vorliegt, genauso bearbeiten wie ein Entwickler, und es kann dabei Daten aus Keyword-Werkzeugen, der Search Console oder dem Hoster abfragen. Was davon taugt, entscheidet nicht das Modell, sondern der Ablauf drumherum.
Der Nutzen liegt nicht im Schreiben von Texten, sondern im Prüfen von Änderungen. Wer Claude Code als schnelleren Textgenerator verwendet, bekommt schneller viele Seiten, und genau das beschreibt Google als Spam: „many pages are generated for the primary purpose of manipulating search rankings and not helping users … no matter how it's created“ (Google, Spam-Richtlinien). Wer es als Arbeitskraft in einem Ablauf mit Prüfschritten einsetzt, bekommt weniger Fehler.
Installieren und was es kostet#
Die empfohlene Installation ist ein einzelner Befehl, unter macOS, Linux und WSL:
curl -fsSL https://claude.ai/install.sh | bashUnter Windows in der PowerShell irm https://claude.ai/install.ps1 | iex, außerdem gibt es Pakete für Homebrew, WinGet, apt, dnf und npm (Anthropic, Setup). Danach im Projektordner claude aufrufen und im Browser anmelden. Die Doku nennt 4 GB Arbeitsspeicher als Untergrenze.
Der Gratis-Tarif von claude.ai reicht nicht: Claude Code verlangt ein Pro-, Max-, Team-, Enterprise- oder Console-Konto. Pro kostet laut Preisseite 20 USD im Monat oder 17 USD bei jährlicher Zahlung, die Max-Tarife ab 100 USD bringen mehr Nutzungskontingent. Für den Einstieg in einem Projekt genügt Pro. Ob das Kontingent reicht, merkt man an langen Sitzungen, nicht an einzelnen Fragen.
Projektregeln: was der Agent bei jedem Start weiß#
Claude Code liest beim Start eine Datei CLAUDE.md im Projekt ein (Anthropic, Memory). Dort steht, was in jeder Sitzung gelten soll: wie gebaut wird, welche Ordner tabu sind, welche Regeln für Texte gelten. Ohne diese Datei erklärt man dieselben Dinge jedes Mal neu, und der Agent rät dazwischen.
Für SEO gehören dort Regeln hinein, die man sonst in einem Gespräch vergisst: Adressen werden nie geändert, noindex und Weiterleitungen nur auf ausdrückliche Anweisung, jede Zahl braucht eine Quelle, Titel höchstens 60 Zeichen. Längere Regelwerke lassen sich auslagern und verweisen. Wiederkehrende Abläufe, etwa „Seite prüfen“ oder „Beitrag gegen die Stilregeln lesen“, lassen sich als Skills ablegen, die Claude Code bei passender Aufgabe selbst lädt (Anthropic, Skills).
Datenquellen per MCP anbinden#
MCP, das Model Context Protocol, ist der Weg, über den Claude Code an Werkzeuge außerhalb des Projekts kommt. Ein MCP-Server stellt dem Agenten Funktionen bereit, etwa „Suchvolumen für diese Begriffe“ oder „letzten Deploy anzeigen“. Angebunden wird er mit einem Befehl (Anthropic, MCP):
claude mcp add --transport http <name> <url>
claude mcp add <name> -- <befehl> [argumente]
Die erste Zeile verbindet einen entfernten Server über HTTP, die zweite startet einen lokalen Server als eigenes Programm. Gespeichert wird je nach Geltungsbereich nur für dich im aktuellen Projekt (local, Standard), für alle deine Projekte (user) oder für alle im Team über eine Datei .mcp.json im Repository (project). Server aus .mcp.json muss man in einer interaktiven Sitzung erst freigeben, bevor sie laufen.
Für SEO-Arbeit sind drei Arten von Quellen nützlich:
- Keyword- und SERP-Daten. DataForSEO bietet einen eigenen MCP-Server. Damit fragt der Agent Suchvolumen, Konkurrenz und Rankings ab, statt sie zu schätzen.
- Hoster und Deploy. Netlify hat einen MCP-Server, über den sich Deploy-Status und Protokolle lesen lassen. Fehlgeschlagene Builds findet der Agent dann selbst.
- Was Google tatsächlich getan hat. Die URL-Inspection-API der Search Console beantwortet pro Adresse, ob sie im Index ist und warum nicht. Sie ist lesend und auf 2.000 Abfragen pro Tag und Property begrenzt (Google, Limits). Ein kleines Skript im Projekt genügt, ein MCP-Server ist dafür nicht nötig.
Jede dieser Quellen hat Grenzen, die der Agent nicht von selbst kennt. Ein SERP-Datenbestand sieht weniger als die Search Console: Für eine Seite von elitegear.io meldete DataForSEO 13 Suchanfragen, die Search Console 73. Was der Bestand meldet, ist echt; was fehlt, ist nicht widerlegt. Solche Einschränkungen gehören in die Projektregeln.
Der Ablauf: Branch, Bau-Prüfung, Pull Request#
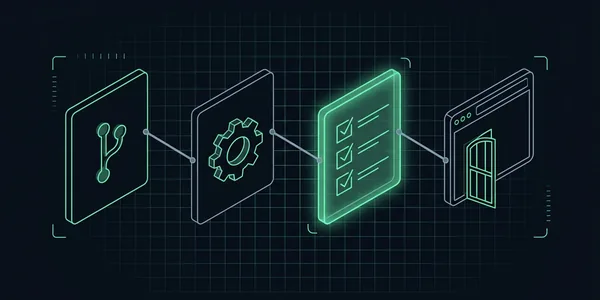
Der Kern ist eine Regel: Nichts geht live, das nicht vorher gebaut und gegen die eigenen Prüfungen gelaufen ist. Claude Code arbeitet deshalb nie direkt auf dem Hauptzweig, sondern so:
- Frage mit Daten klären. Bevor eine Seite geändert wird, fragt der Agent ab, wofür sie rankt und was Google über sie meldet. „Seite ist schlecht“ ist keine Aufgabe, „rankt auf Platz 14 für eine Suche, die sie nicht beantwortet“ schon.
- Branch anlegen und ändern. Eine Aufgabe, ein Branch. Wer zehn Änderungen in einen Branch packt, kann später nicht sagen, welche gewirkt hat.
- Bauen und prüfen. Der Bau bricht ab, wenn etwas nicht stimmt: fehlende Beschreibung, unbekannte Rubrik, falsche Überschriftenebene. Danach ein Prüfskript gegen das Ergebnis, das Widersprüche meldet, die Google zum Liegenlassen einer Seite bringen:
noindexund trotzdem in der Sitemap, Canonical zeigt woandershin, doppelte Titel, Seiten mit sehr wenig Text. Mehr dazu in Warum Google Seiten nicht indexiert. - Pull Request statt Push. Der Agent eröffnet einen Pull Request mit Beschreibung. Zusammengeführt wird erst, wenn die automatischen Prüfungen grün sind und ein Mensch die Änderung gelesen hat.
- Nach dem Livegang messen und melden. Live-Seite gegen den erwarteten Stand prüfen, geänderte Adressen über IndexNow an Bing und Yandex melden, in der Search Console einzeln die URL-Prüfung aufrufen. Wie lange Google dann noch braucht, steht in Wie lange dauert die Indexierung bei Google.
Schritt 5 zeigt, wo die Grenze liegt: Google lässt sich nicht drängen. Die Schaltfläche „Indexierung beantragen“ hatte in eigener Messung vom 26.08.2026 ein Kontingent von rund zwei Anfragen am Tag, für alle Properties eines Kontos zusammen. Ein Agent, der das nicht weiß, verbraucht es am Vormittag.
In eigener Sache: So wird dieses Magazin gepflegt#
Dieses Magazin und die Werkzeuge liegen als Code in einem Repository und werden mit genau diesem Ablauf bearbeitet. Ich gebe Claude Code die Aufgabe, er legt einen Branch an, ändert, baut, lässt die Prüfskripte laufen und eröffnet einen Pull Request. Gelesen und freigegeben wird von mir.
Die Regeln für Texte stehen in zwei Dateien im Repository: BRAND.md legt fest, welche Felder ein Beitrag hat, welche Quellen zählen und was verboten ist; VOICE.md beschreibt die Stimme mit gemessenen Werten aus dem Bestand. Der Bau prüft die harten Regeln, die weichen prüft ein Mensch. Die Keyword-Daten kommen über DataForSEO, der Deploy-Status über Netlify, der Indexstand über ein Skript gegen die URL-Inspection-API. Für elitegear.io läuft derselbe Ablauf.
Was dabei auffällt: Die meiste Zeit spart nicht das Schreiben, sondern das Nachsehen. Ein Agent, der vor jeder Änderung 40 Adressen gegen die Search Console abfragt und nach jedem Bau die Widersprüche auflistet, findet Fehler, die man beim Klicken übersieht. Den eigenen Stand von außen prüft der SEO-Audit.
Sicherheit: Rechte, Zugangsdaten, fremder Code#
Ein Agent im Terminal hat die Rechte deines Benutzerkontos. Claude Code fragt deshalb je nach Modus nach, bevor es Dateien ändert oder Befehle ausführt. Im Modus default (in der Oberfläche „Manual“) laufen ohne Rückfrage nur Lesezugriffe, acceptEdits erlaubt zusätzlich Dateiänderungen, auto lässt einen zweiten Prüfer im Hintergrund entscheiden. bypassPermissions erlaubt alles und ist laut Doku nur für isolierte Container und virtuelle Maschinen gedacht (Anthropic, Permission Modes). Auf dem Rechner, auf dem dein Hoster-Zugang liegt, gehört er nicht hin.
Drei Regeln, die mehr bringen als jeder Modus:
- Zugangsdaten nie in den Chat und nicht offen in
.env-Dateien im Projekt. Was im Gespräch steht, liest das Modell; was im Projekt liegt, kann in einem Commit landen. Schlüssel gehören in den Schlüsselbund des Betriebssystems und werden von einem kleinen Startskript eingelesen. - Keine Kundendaten in die Sitzung. Für Kundenprojekte gilt dasselbe wie für jeden KI-Anbieter: Tarif und Vertrag klären, bevor etwas hineinfließt. Siehe Auftragsverarbeitungsvertrag mit KI-Anbietern.
- Jeder MCP-Server ist fremder Code mit deinen Rechten. Anthropic schreibt selbst: Server, die externe Inhalte abrufen, setzen dich Prompt Injection aus. Eine Website, die der Agent für eine SERP-Analyse liest, kann Anweisungen enthalten. Wie man Server auswählt und eingrenzt, steht in MCP-Server sicher einsetzen; was ein Agent mit zu weiten Rechten anrichtet, in KI-Agenten: Sicherheit und Risiken.
Was nicht hilft#
Massenhaft Seiten erzeugen lassen. Zwanzig Ratgeber an einem Nachmittag sind genau das Muster, das Google als „scaled content abuse“ beschreibt, egal ob ein Mensch oder ein Modell sie geschrieben hat. Google bewertet KI-Inhalte nach ihrem Nutzen, nicht nach ihrer Herkunft (Google, KI-generierte Inhalte), aber der Nutzen fehlt bei Massenware fast immer.
Ungeprüft zusammenführen. Ein Agent, der einen Titel ändert, ändert manchmal auch die Adresse, die Weiterleitung oder das Canonical. Das sieht man im Diff, nicht im Ergebnis.
Alles auf einmal ändern. Fünf Wellen aus noindex, Weiterleitungen und Sitemap-Änderungen in drei Wochen lassen Google ein widersprüchliches Bild zurück, und das Aufräumen dauert länger als das Ändern. Eine Änderung pro Branch, und Struktur nur dann anfassen, wenn sie danach eine Weile so bleibt.
llms.txt als Abkürzung. Für Sichtbarkeit in KI-Suchen ist die Datei wenig wirksam, siehe llms.txt. Was dort tatsächlich zählt, steht in GEO und SEO.
Der ehrliche Schluss#
Claude Code macht aus SEO keine Knopfdruck-Arbeit. Es macht die langweiligen Teile billig: Daten abfragen, Widersprüche finden, Prüfungen laufen lassen, Änderungen sauber dokumentieren. Die Entscheidung, was eine Seite beantworten soll, und das Lesen vor dem Zusammenführen bleiben bei dir. Wer den Ablauf mit Branch, Bau-Prüfung und Pull Request einmal steht, kann den Agenten mehr tun lassen, weil jeder Fehler vor dem Livegang auffällt und nicht danach.
Stand 04.10.2026. Installationswege, Tarife und Rechte-Modi aus der Anthropic-Dokumentation vom selben Tag.
Weiterlesen
Kommentare
Gespeichert werden nur dein Name und dein Text — keine E-Mail-Adresse, keine IP-Adresse, kein Cookie. Jeder Kommentar wird vor der Veröffentlichung gelesen; das dauert meist einen Tag. Näheres in der Datenschutzerklärung.